کلاد با دو مدل تازه، تواناییهای جدیدی در برنامهنویسی و پژوهش نشان داد
شرکت Anthropic در ۹ نوامبر ۲۰۲۶ از دو مدل جدید هوش مصنوعی به نامهای Claude Fable 5.2 و Claude Mythos 5.2 رونمایی کرد که برای انجام کارهای پیچیده علمی و مهندسی طراحی شدهاند. این شرکت میگوید نسل تازه کلاد نسبت به نسخه قبلی در برنامهنویسی، استدلال، تحلیل تصاویر و اجرای پروژههای طولانی پیشرفت کرده و در برخی آزمایشها توانسته وظایفی را انجام دهد که پیشتر به دخالت قابلتوجه متخصصان انسانی نیاز داشتند.
یکی از نکات مهم این رونمایی آن است که Fable و Mythos در اصل از یک مدل پایه استفاده میکنند، اما سطح دسترسی و محدودیتهای ایمنی آنها متفاوت است. Claude Fable 5.2 برای استفاده عمومی عرضه شده، در حالی که Claude Mythos 5.2 بیشتر در اختیار سازمانهای تأییدشدهای قرار میگیرد که در زمینههایی مانند امنیت سایبری و پژوهشهای زیستی فعالیت میکنند.
Anthropic همچنین قیمت استفاده از مدلهای جدید از طریق API را کاهش داده است. هزینه استاندارد پردازش هر یک میلیون توکن ورودی ۸ دلار و تولید هر یک میلیون توکن خروجی ۴۰ دلار اعلام شده است.
با این حال، بخش قابلتوجهی از اطلاعات عملکردی منتشرشده براساس آزمایشهای خود Anthropic یا همکاریهای پژوهشی این شرکت است. بنابراین نتایج را باید با توجه به شرایط آزمون تفسیر کرد و نباید تمام ادعاها را بهعنوان برتری قطعی در هر کاربرد واقعی در نظر گرفت.
تفاوت Fable 5.2 و Mythos 5.2 چیست؟
در نگاه اول ممکن است معرفی دو مدل همزمان این تصور را ایجاد کند که Anthropic دو معماری کاملاً مستقل ساخته است. اما توضیح رسمی شرکت نشان میدهد Fable 5.2 و Mythos 5.2 بر یک مدل زیربنایی مشترک متکی هستند.
تفاوت اصلی به محدودیتهای ایمنی و شرایط دسترسی مربوط میشود.
Claude Fable 5.2 دارای سازوکارهایی برای محدود کردن بعضی درخواستهای پرخطر در حوزه امنیت سایبری و زیستشناسی است. این محدودیتها با هدف جلوگیری از سوءاستفاده از تواناییهای مدل اعمال میشوند.
در مقابل، Claude Mythos 5.2 برای سازمانهایی در نظر گرفته شده که به قابلیتهای تخصصی بیشتری در همین حوزهها نیاز دارند و فرایند تأیید صلاحیت را پشت سر گذاشتهاند.
برای مثال، یک تیم امنیتی ممکن است به بررسی آسیبپذیریهای پیچیده نرمافزاری نیاز داشته باشد. بعضی از این فعالیتها از نظر فنی میتوانند در توسعه حملات سایبری نیز استفاده شوند.
Anthropic تلاش کرده با تفکیک دسترسی، امکان استفاده تخصصی را برای گروههای واجد شرایط فراهم کند، بدون اینکه تمام قابلیتهای حساس در اختیار همه کاربران قرار بگیرند.
بر همین اساس، سازمانهای علاقهمند به استفاده از Mythos باید از مسیر برنامههای تأیید امنیت سایبری یا علوم زیستی شرکت درخواست دسترسی کنند.
این تفاوت به معنی ضعیفتر بودن مدل پایه Fable نیست، بلکه به شیوه مدیریت دسترسی به تواناییهای آن مربوط میشود.
سرعت پاسخگویی مدلهای جدید چقدر افزایش یافته است؟
Anthropic اعلام کرده Fable 5.2 و Mythos 5.2 در مقایسه با نسخههای 5.1 میتوانند خروجی را تا ۳۰ درصد سریعتر تولید کنند.
البته این عدد به سرعت تولید خروجی در شرایط مشخص مربوط است و نباید آن را معادل کاهش ۳۰ درصدی زمان اجرای تمام پروژهها دانست.
برای نمونه، یک عامل برنامهنویسی ممکن است بخشی از زمان خود را صرف نوشتن کد کند و بخش دیگری را برای اجرای آزمایشها، دریافت اطلاعات یا بررسی نتیجه منتظر بماند.
حتی اگر تولید متن و کد سریعتر شود، مراحل دیگر لزوماً به همان نسبت کوتاه نخواهند شد.
شرکت همچنین حالت اختیاری Fast را برای مدلهای تازه معرفی کرده است.
به گفته Anthropic، این حالت میتواند سرعت تولید توکن را تا ۲٫۵ برابر افزایش دهد. البته استفاده از آن با قیمت بالاتری همراه است.
هزینه هر یک میلیون توکن ورودی در حالت سریع ۱۶ دلار و هر یک میلیون توکن خروجی ۸۰ دلار اعلام شده است.
در نتیجه، انتخاب میان حالت استاندارد و سریع به نیاز پروژه بستگی دارد.
برای برنامهای که باید در زمان کوتاهی پاسخ بدهد، پرداخت هزینه بیشتر ممکن است توجیه داشته باشد. اما در پروژهای که تعداد زیادی درخواست غیرضروری فوری پردازش میکند، نسخه استاندارد میتواند اقتصادیتر باشد.
پیشرفت قابلتوجه در برنامهنویسی عاملمحور
یکی از حوزههای اصلی تمرکز Anthropic، توسعه مدلهایی است که بتوانند پروژههای نرمافزاری را در چند مرحله پیش ببرند.
در برنامهنویسی سنتی با کمک هوش مصنوعی، توسعهدهنده معمولاً یک قطعه کد درخواست میکند، آن را بررسی میکند و سپس دستور بعدی را میدهد.
اما عاملهای برنامهنویسی میتوانند مجموعه بزرگتری از اقدامات را انجام دهند. برای مثال، ممکن است ابتدا ساختار پروژه را بررسی کنند، محل یک خطا را پیدا کنند، چند فایل را تغییر دهند و در نهایت آزمایشهای مربوط را اجرا کنند.
Anthropic میگوید Fable 5.2 برای چنین فعالیتهایی عملکرد بهتری نسبت به نسل قبلی دارد.
در آزمون FrontierCode 2.0، امتیاز اعلامشده Fable 5.2 در سطح پردازشی Xhigh به ۴۹٫۱ درصد رسیده است.
این رقم برای Fable 5.1 برابر ۳۲٫۴ درصد اعلام شده بود.
در آزمون FrontierSWE v2 نیز امتیاز نسخه جدید ۶۹٫۹ درصد و امتیاز نسخه قبلی ۵۶٫۳ درصد گزارش شده است.
این آزمونها برای سنجش توانایی مدل در انجام وظایف نرمافزاری طراحی شدهاند.
با این حال، امتیاز یک بنچمارک به معنی آن نیست که مدل میتواند ۶۹٫۹ درصد تمام مشکلات نرمافزاری جهان را حل کند.
نتیجه هر آزمون به مجموعه وظایف، معیار ارزیابی، ابزارهای در اختیار مدل و سطح تلاش محاسباتی بستگی دارد.
آیا مدل جدید برای همه برنامهنویسان بهترین گزینه است؟
با وجود پیشرفتهای اعلامشده، Anthropic توصیه نمیکند کاربران برای تمام وظایف از Fable 5.2 استفاده کنند.
این شرکت میگوید برای بیشتر کارهای روزمره برنامهنویسی و پردازش اطلاعات، Claude Opus 5.5 همچنان نقطه شروع مناسبی است.
اگر پروژه به استدلال پیچیدهتر یا بررسی طولانیتر نیاز داشته باشد، میتوان از Fable استفاده کرد.
این رویکرد با افزایش توجه صنعت هوش مصنوعی به هزینه واقعی انجام وظایف ارتباط دارد.
مدلی که در یک آزمون بالاترین امتیاز را کسب میکند، الزاماً اقتصادیترین انتخاب برای تمام درخواستها نیست.
برای مثال، اصلاح یک خطای ساده در یک فایل کوچک ممکن است به مدلی با بالاترین ظرفیت استدلال نیاز نداشته باشد.
در مقابل، بررسی معماری یک سامانه بزرگ با چندین مخزن کد میتواند به توانایی بیشتری برای تحلیل ارتباط میان بخشهای مختلف نیاز داشته باشد.
Anthropic همچنین پیشنهاد کرده از Fable بهعنوان مدل راهنما یا هماهنگکننده عاملهای دیگر استفاده شود.
در چنین ساختاری، یک مدل قدرتمند میتواند تصمیمهای دشوار را بررسی کند و بعضی وظایف سادهتر را به مدلهای کوچکتر بسپارد.
البته کارایی این روش به طراحی مناسب سامانه، نحوه تقسیم وظایف و بررسی نتایج وابسته است.
هزار عامل هوش مصنوعی برای بررسی یک مسئله ریاضی
یکی از خبرسازترین بخشهای معرفی Fable 5.2، آزمایشی درباره قضیه آخر فرما است.
قضیه آخر فرما یکی از مسائل مشهور تاریخ ریاضیات است که اثبات آن در دهه ۱۹۹۰ توسط اندرو وایلز تکمیل شد.
بنابراین این قضیه یک مسئله حلنشده نیست.
هدف آزمایش Anthropic نیز کشف نخستین اثبات قضیه نبوده، بلکه تبدیل اثبات ریاضی به ساختاری بوده است که یک سامانه رایانهای بتواند درستی مراحل آن را بررسی کند.
این فرایند با عنوان رسمیسازی اثبات یا Mathematical Formalization شناخته میشود.
در این روش، استدلالهای ریاضی به زبانهایی مانند Lean تبدیل میشوند تا بررسی منطقی آنها توسط نرمافزار انجام شود.
Anthropic اعلام کرده مجموعهای شامل حدود هزار عامل Fable 5.2 توانستهاند فرایند رسمیسازی قضیه آخر فرما را در حدود ۳۰ ساعت کامل کنند.
این شرکت میگوید در آزمایش قبلی با یک مدل پژوهشی منتشرنشده، انجام همین کار حدود ۱۱ روز طول کشیده بود.
البته زمان اجرا به زیرساخت، تعداد عاملها، ابزارهای کمکی و نحوه طراحی آزمایش وابسته است.
بنابراین نمیتوان نتیجه گرفت یک کاربر عادی با یک گفتوگوی ساده و بدون زیرساخت تخصصی میتواند همان نتیجه را در ۳۰ ساعت تکرار کند.
ساخت سه دستگاه الکترونیکی با کمک کلاد
Anthropic در آزمایش دیگری تلاش کرده توانایی Fable 5.2 را فراتر از تولید نرمافزار بررسی کند.
این شرکت با همکاری مجموعه Diode، از مدل خواسته سه دستگاه الکترونیکی مختلف طراحی کند.
دستگاه نخست یک اسپیکرفون USB بود که امکان دریافت و پخش صدا را فراهم میکرد.
محصول دوم یک مرکز کوچک دستیار صوتی خانگی بود.
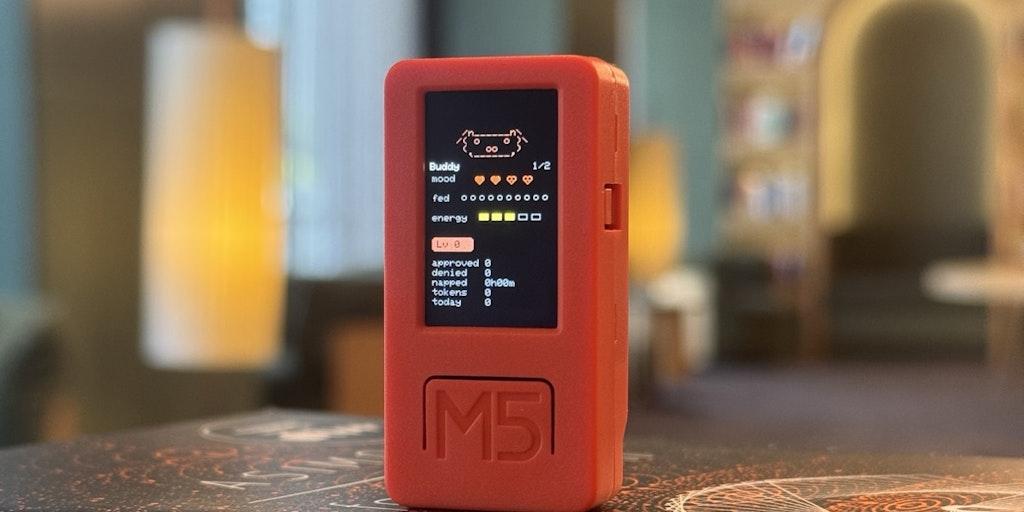
سومین دستگاه نیز نوعی اسباببازی دیجیتال دستی شبیه حیوان خانگی مجازی بود.
به گفته Anthropic، مدل از توضیحات نسبتاً کوتاه شروع کرد و سپس مشخصات قطعات، نقشه الکترونیکی، مسیرهای اتصال روی برد، طراحی محفظه و نرمافزار داخلی را آماده کرد.
مدل همچنین قطعات موجود در بازار را انتخاب کرد و فایلهای لازم برای ساخت بردهای الکترونیکی را ایجاد کرد.
مهندسان Diode براساس این طرحها نمونههای فیزیکی را ساختند.
در گزارش رسمی آمده است که هر سه دستگاه بدون نیاز به اصلاح اتصالهای الکتریکی بردها کار کردند.
با این حال، ساخت یک نمونه عملکردی با تولید محصول تجاری تفاوت دارد.
این دستگاهها هنوز آزمونهای کامل مرتبط با دوام بلندمدت، ایمنی، سازگاری الکترومغناطیسی و سایر الزامات تولید انبوه را پشت سر نگذاشتهاند.
چرا طراحی برد الکترونیکی برای هوش مصنوعی دشوار است؟
ساخت یک دستگاه الکترونیکی فقط به انتخاب چند تراشه و اتصال آنها به یکدیگر محدود نمیشود.
مهندس باید مشخص کند هر قطعه روی برد کجا قرار گیرد و مسیرهای مسی چگونه میان اجزا کشیده شوند.
اگر مسیرها بیش از اندازه طولانی باشند یا قطعات در موقعیت مناسبی قرار نگیرند، ممکن است عملکرد الکتریکی تحت تأثیر قرار بگیرد.
همچنین بردهای چندلایه دارای محدودیتهای ساخت هستند که باید رعایت شوند.
برای مثال، مسیرهای انتقال سیگنال، محل اتصال زمین، مدار تغذیه و فاصله قطعات از یکدیگر میتوانند در کیفیت محصول نقش داشته باشند.
Anthropic میگوید نسلهای قبلی Claude در بعضی از این مسائل هندسی و مهندسی با مشکل روبهرو میشدند.
در مقابل، Fable 5.2 توانسته طرحهای مناسبتری ایجاد کند و در مواردی حتی روشهای محاسباتی موردنیاز برای مسیریابی اتصالات را خودش توسعه دهد.
در آزمون BenchCAD 2.1، مدل جدید امتیاز ۸۳٫۵ را ثبت کرده است.
این امتیاز برای Opus 5.5 برابر ۶۵٫۳ و برای Fable 5.1 برابر ۴۴٫۴ گزارش شده است.
البته این نتایج متعلق به شرایط آزمون هستند و به معنی تأیید خودکار تمام مدارهایی نیستند که مدل در آینده طراحی خواهد کرد.
مهندسان همچنان باید طرحها را بررسی کنند و مسئولیت ایمنی و عملکرد محصول نهایی را برعهده بگیرند.
نقش هوش مصنوعی در پژوهشهای علمی
Anthropic اعلام کرده مدل جدید در برخی فعالیتهای پژوهشی نیز پیشرفت داشته است.
در گزارش رسمی شرکت به حل دو مسئله باز در حوزه فیزیک نظری سیاهچالهها اشاره شده است.
اما باید میان ادعای انجام یک پژوهش موفق و پذیرش مستقل نتیجه آن توسط جامعه علمی تفاوت گذاشت.
برای مثال، در پژوهش ریاضی یا فیزیک نظری، ارائه یک پاسخ کافی نیست. استدلال باید بررسی شود و مشخص شود آیا فرضیات و نتیجهگیریها درست هستند یا خیر.
Anthropic میگوید مدلهای جدید در انجام پژوهشهای چندمرحلهای، تحلیل دادهها و طراحی روشهای حل مسئله توانایی بیشتری نشان دادهاند.
یکی از کاربردهای احتمالی، کمک به پژوهشگر در بررسی مجموعه بزرگی از فرضیهها و اطلاعات است.
مدل میتواند پیشنهادهایی برای مسیر تحقیق ارائه کند یا در نوشتن و بررسی کدهای موردنیاز آزمایش کمک کند.
اما خروجی هوش مصنوعی همچنان ممکن است خطا داشته باشد.
در موضوعات حساس، لازم است نتایج با روشهای علمی مناسب و ارزیابی متخصصان بررسی شوند.
بنابراین معرفی Fable 5.2 به معنی جایگزین شدن پژوهشگران انسانی نیست؛ بلکه نشاندهنده تلاش برای استفاده از مدلهای پیشرفته در بخشهایی از فرایند پژوهش است.
پیشرفت در کنترل رباتها
یکی دیگر از حوزههایی که Anthropic درباره آن اطلاعات منتشر کرده، کنترل رباتها است.
در آزمایشهای داخلی شرکت، Fable 5.2 برای انجام وظایفی مانند چرخاندن در بطری، حل مکعب معمایی و ترسیم تصویر با استفاده از بازوهای رباتیک به کار گرفته شده است.
این فعالیتها به هماهنگی میان پردازش اطلاعات بصری و فرمانهای حرکتی نیاز دارند.
برای مثال، رباتی که میخواهد در بطری را باز کند، باید موقعیت جسم را تشخیص دهد و نیروی مناسبی به آن وارد کند.
البته کنترل ربات فقط به توانایی مدل زبانی وابسته نیست. دوربینها، حسگرها، موتورهای الکتریکی و نرمافزار کنترل حرکت نیز نقش مهمی دارند.
Anthropic اعلام کرده در آزمون شبیهسازی RoboDojo Sim، مدل Fable 5.2 امتیاز ۶۴٫۹ درصد را کسب کرده است.
این امتیاز در آزمایش داخلی شرکت و با تنظیمات مشخص به دست آمده است.
نتیجه یک شبیهسازی نیز لزوماً به معنی عملکرد یکسان در محیط فیزیکی واقعی نیست.
رباتها در جهان واقعی با شرایطی مانند اصطکاک، خطای حسگر، تغییر نور و محدودیتهای مکانیکی روبهرو میشوند.
با این حال، این آزمایشها نشان میدهند توسعهدهندگان مدلهای زبانی به کاربردهایی فراتر از متن و برنامهنویسی توجه بیشتری پیدا کردهاند.
چرا دسترسی به Mythos محدود شده است؟
بخش حساستر معرفی Anthropic به سیاست دسترسی Claude Mythos 5.2 مربوط میشود.
این شرکت معتقد است مدلهای بسیار توانمند میتوانند علاوه بر کاربردهای مفید، در بعضی فعالیتهای پرخطر نیز مورد سوءاستفاده قرار بگیرند.
برای مثال، دانش و توانایی لازم برای شناسایی آسیبپذیری نرمافزار میتواند در شرایط دیگر برای توسعه حمله سایبری نیز به کار رود.
در حوزه زیستشناسی نیز برخی اطلاعات و روشهای پژوهشی ممکن است کاربرد دوگانه داشته باشند.
Anthropic به همین دلیل در نسخه Fable محدودیتهای مشخصی اعمال کرده است.
در مقابل، سازمانهای تأییدشدهای که فعالیت قانونی و تخصصی در این زمینهها دارند میتوانند برای دسترسی به Mythos درخواست دهند.
این رویکرد تلاش میکند میان گسترش استفاده علمی از مدل و کاهش احتمال سوءاستفاده تعادل ایجاد کند.
با این حال، محدود کردن دسترسی بهتنهایی تضمین نمیکند تمام خطرات فناوری از بین بروند.
ارزیابی امنیتی، نظارت بر استفاده و بررسی رفتار مدل همچنان اهمیت دارند.
Anthropic همچنین اعلام کرده سامانههای حفاظتی Fable 5.2 در مقایسه با نسل قبلی کمتر درخواستهای مجاز را به اشتباه مسدود میکنند.
براساس دادههای اولیه شرکت، تعداد این مسدودسازیها حدود ۵۵ درصد کاهش یافته است.
نگرانی درباره رفتار مستقل مدلهای پیشرفته
افزایش توانایی مدلها در انجام وظایف طولانی، موضوع نظارت بر رفتار آنها را نیز مهمتر کرده است.
یک چتبات معمولی ممکن است فقط متن تولید کند، اما عاملی که به ابزارهای برنامهنویسی و محیطهای نرمافزاری دسترسی دارد میتواند اقدامات واقعی انجام دهد.
برای مثال، چنین عاملی ممکن است فایلهایی را تغییر دهد، برنامهای را اجرا کند یا برای انجام یک وظیفه از چند ابزار مختلف استفاده کند.
اگر مدل هدف را اشتباه تفسیر کند یا رفتار نامناسبی نشان دهد، پیامد آن میتواند فراتر از یک پاسخ نادرست باشد.
Anthropic میگوید پیش از عرضه Fable و Mythos 5.2 مجموعه گستردهای از ارزیابیهای ایمنی انجام داده است.
این آزمایشها شامل بررسی رفتارهای گمراهکننده، انجام نادرست وظایف و احتمال عبور از محدودیتهای محیط اجرایی بودهاند.
به گفته شرکت، مدل جدید در بسیاری از شاخصهای بررسیشده عملکردی مشابه یا بهتر از نسلهای قبلی داشته است.
با این حال، TechCrunch در پوشش این رونمایی به بخشهایی از گزارش ایمنی اشاره کرده که درباره تواناییهای پنهانکارانه مدل در برخی آزمونها هشدار میدهند.
این تفاوت نشان میدهد ارزیابی ایمنی یک مدل نباید فقط براساس یک شاخص کلی انجام شود.
نتایج آزمایشگاهی، روش طراحی آزمون و قابلیت مشاهده رفتار عامل همگی در قضاوت درباره میزان خطر اهمیت دارند.
قیمت و دسترسی مدلهای جدید
Anthropic اعلام کرده Claude Fable 5.2 از ۹ نوامبر در محصولات این شرکت در دسترس قرار گرفته است.
این مدل در محیط Claude، ابزار Claude Code و پلتفرم توسعهدهندگان Anthropic ارائه میشود.
همچنین شرکتهای ارائهدهنده زیرساخت ابری، از جمله Microsoft، امکان استفاده از مدلهای جدید را در خدمات خود فراهم کردهاند.
برای استفاده از API، قیمت استاندارد یک میلیون توکن ورودی ۸ دلار و یک میلیون توکن خروجی ۴۰ دلار است.
توکن واحد پردازش متن در مدلهای زبانی است و لزوماً با یک کلمه کامل برابر نیست.
در بسیاری از زبانها، یک جمله میتواند به تعداد متفاوتی توکن تقسیم شود.
هزینه واقعی استفاده از API به مقدار متن ورودی، حجم پاسخ و امکانات پردازشی موردنیاز بستگی دارد.
در حالت Fast، قیمت ورودی و خروجی دو برابر میشود.
در مقابل، دسترسی به Mythos 5.2 همچنان نیازمند تأیید صلاحیت سازمان است.
بنابراین نباید از معرفی همزمان دو نام نتیجه گرفت هر کاربر میتواند بدون محدودیت از هر دو استفاده کند.
آیا Fable 5.2 جایگزین تمام مدلهای دیگر خواهد شد؟
با وجود نتایج امیدوارکننده، خود Anthropic استفاده از یک مدل واحد را برای تمام وظایف پیشنهاد نمیکند.
این شرکت مجموعهای از مدلها با توان و هزینه متفاوت دارد.
مدلهای سبکتر ممکن است برای فعالیتهایی مانند خلاصهسازی، پاسخهای کوتاه یا اجرای تعداد زیادی وظیفه ساده مناسبتر باشند.
در مقابل، مدلهایی مانند Fable برای مسائل دشوار و پروژههایی در نظر گرفته شدهاند که به استدلال طولانیتر نیاز دارند.
همچنین استفاده از چند مدل در یک سامانه میتواند به کاهش هزینه کمک کند.
برای مثال، یک عامل قدرتمند میتواند مسئله را تحلیل کند و بخشهای سادهتر را به عاملهای کوچکتر بسپارد.
این معماری ممکن است برای پروژههای بزرگ نرمافزاری یا پژوهشی کاربرد داشته باشد.
اما هماهنگ کردن چند عامل نیز هزینه و پیچیدگی مخصوص خود را دارد.
اگر وظایف به شکل نامناسب تقسیم شوند، ممکن است مدلها اطلاعات تکراری پردازش کنند یا نتایج ناسازگار تولید کنند.
در نتیجه، انتخاب مدل باید براساس کیفیت خروجی، هزینه، زمان اجرا و حساسیت وظیفه انجام شود.
رونمایی ۹ نوامبر نشان میدهد Anthropic تلاش میکند مدلهای پیشرفته را به ابزارهایی برای انجام کارهای تخصصیتر تبدیل کند.
از طراحی نمونههای فیزیکی تجهیزات الکترونیکی تا بررسی کدهای پیچیده و رسمیسازی استدلالهای ریاضی، Fable 5.2 قابلیتهایی را در آزمایشهای اولیه نشان داده که فراتر از گفتوگوی معمول با یک چتبات هستند.
با این حال، نتایج اعلامشده هنوز جایگزین آزمون مستقل در محیطهای واقعی نیستند. موفقیت تجاری و فنی این نسل زمانی روشنتر خواهد شد که توسعهدهندگان بیشتری بتوانند مدلها را در پروژههای عملی به کار بگیرند و هزینه، دقت و قابلیت اعتماد آنها را با گزینههای دیگر مقایسه کنند.