خریدهای مرموز کتابهای قدیمی؛ آیا شرکتهای هوش مصنوعی بهدنبال آموزش چتباتها هستند؟
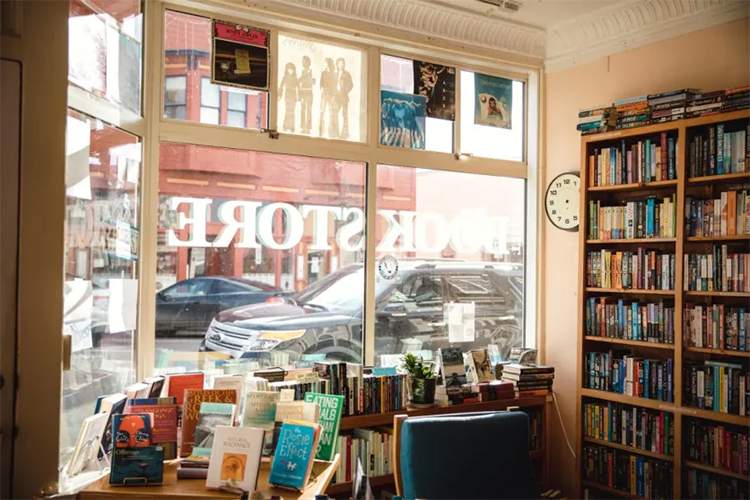
این سفارشها گاهی صدها یا هزاران عنوان مختلف را شامل میشوند؛ از کتابهای تخصصی درباره کشاورزی و تاریخ گرفته تا زندگینامه رانندگان مسابقات اتومبیلرانی، ترجمههای کمیاب و حتی مجلات قدیمی.
همین ترکیب نامتعارف باعث شده برخی فروشندگان احتمال دهند خریداران به دنبال مطالعه این آثار نیستند، بلکه میخواهند محتوای آنها را برای استفاده در آموزش مدلهای هوش مصنوعی استخراج کنند.
استوارت منلی، یکی از مالکان کتابفروشی Barter Books در انگلستان، میگوید سه خریدار مختلف طی چند ماه صدها کتاب از فروشگاه او خریداری کردهاند که مجموع ارزش سفارشهایشان به حدود چهار هزار پوند رسیده است. یکی از سفارشها شامل نسخهای استونیایی از رمان «آواز مأموریت» جان لوکاره، چاپ مشخصی از کتاب «اگنس گری» نوشته آن برونته و شماره اکتبر ۱۹۸۳ مجله Warship بوده است.
از نظر منلی، چنین ترکیبی با سفارشهای معمول کتابفروشیها تفاوت اساسی دارد؛ زیرا خریدهای عمده سنتی معمولاً حول یک موضوع مشخص، مانند ورزش یا خودرو، شکل میگیرند.
در ایرلند نیز جیم شاناگسی، مالک فروشگاه MW Books، از دریافت سفارشهایی مشابه از ماه مه خبر داده است. او میگوید درخواستها ظاهراً بهصورت ماشینی ثبت میشوند و موضوعات انتخابشده ارتباط مشخصی با یکدیگر ندارند.
چرا شرکتهای هوش مصنوعی به کتابهای قدیمی نیاز دارند؟
مدلهای زبانی بزرگ برای یادگیری و تولید پاسخ، به حجم عظیمی از دادههای متنی نیاز دارند. بخش قابلتوجهی از این دادهها از اینترنت جمعآوری میشود؛ اما محتوای آنلاین محدودیتهایی دارد.
بسیاری از کتابهای قدیمی، پژوهشهای تخصصی، ترجمههای نایاب و نشریات چاپی یا هرگز به شکل دیجیتال منتشر نشدهاند یا نسخه قابلدسترسی آنها در اینترنت وجود ندارد. این آثار میتوانند اطلاعاتی در اختیار مدلهای هوش مصنوعی قرار دهند که در مجموعهدادههای رایج پیدا نمیشود.
همچنین کتابهایی که پیش از گسترش هوش مصنوعی مولد منتشر شدهاند، از این نظر اهمیت دارند که محتوای آنها محصول تولید انبوه متن توسط چتباتها نیست. بنابراین میتوانند برای توسعهدهندگانی که به دنبال دادههای انسانی و غیربازساخته هستند، جذاب باشند.
پروژه جنجالی Anthropic؛ کتابها اسکن و بازیافت شدند
شکوتردید کتابفروشان بیارتباط با اتفاقات پیشین در صنعت هوش مصنوعی نیست. پیشتر گزارشهایی منتشر شده بود که نشان میداد شرکت Anthropic، سازنده چتبات Claude، میلیونها کتاب چاپی خریداری کرده تا محتوای آنها را به شکل دیجیتال استخراج کند.
این عملیات که با نام داخلی «Project Panama» شناخته میشود، شامل جداکردن عطف کتابها، اسکن صنعتی صفحات و سپس بازیافت نسخههای فیزیکی بود. گزارشها حاکی از آن است که این شرکت برای تهیه کتابها دهها میلیون دلار هزینه کرده است.
Anthropic اعلام کرده است که مدل Claude با ترکیبی از دادههای عمومی اینترنت، مجموعهدادههای خریداریشده و دادههای تولیدشده توسط خود شرکت آموزش دیده است. این شرکت همچنین گفته است برنامههای تأمین داده آن شامل خرید و تخریب کتابهای کمیاب و عتیقه نمیشود.
پرونده حقوقی مرتبط با استفاده از کتابهای بدون مجوز نیز به یکی از مهمترین مناقشات صنعت هوش مصنوعی تبدیل شد.
Anthropic در پروندهای جداگانه با توافقی به ارزش ۱.۵ میلیارد دلار برای حلوفصل ادعاهای مربوط به استفاده از نسخههای غیرقانونی کتابها موافقت کرد؛ توافقی که به معنای پذیرش مسئولیت حقوقی از سوی شرکت نبود.
سفارشهای مشکوک، اما بدون مدرک قطعی
گزارشهای کتابفروشان نشان میدهد برخی سفارشها با نامهای مستعار ثبت شدهاند و در مواردی نشانی تحویل مشترکی برای خریداران مختلف گزارش شده است. بخشی از محمولهها ظاهراً به انبارهای حملونقل در نزدیکی فرودگاه هیترو لندن ارسال میشوند.
با این حال، هنوز مشخص نیست چه شخص یا شرکتی پشت این سفارشها قرار دارد و آیا همه خریداران با یکدیگر ارتباط دارند یا خیر.
یکی از نامهایی که در این زمینه مطرح شده، شرکت کانادایی Zoom Books است که در زمینه بازیافت کتاب فعالیت میکند؛ اما ارتباط این شرکت با توسعهدهندگان هوش مصنوعی یا سفارشهای مشکوک اثبات نشده است.
از سوی دیگر، برخی فروشندگان به نکتهای اشاره میکنند که فرضیه آموزش هوش مصنوعی را پیچیدهتر میکند: در میان کتابهای سفارشدادهشده، آثاری مانند «سفرهای گالیور» جاناتان سویفت نیز وجود داشتهاند که متن آنها بهصورت رایگان در اینترنت در دسترس است. بنابراین هنوز نمیتوان با اطمینان گفت هدف تمام این خریدها استخراج داده برای آموزش مدلهاست.
چالش حقوقی تازه برای صنعت نشر
این ماجرا علاوه بر جنبه تجاری، پرسشهای مهمی درباره مالکیت فکری ایجاد میکند. قوانین کپیرایت در کشورهای مختلف یکسان نیستند و خرید قانونی یک نسخه فیزیکی از کتاب لزوماً به معنای مجازبودن تمام شکلهای استفاده از محتوای آن نیست.
در بریتانیا، تکثیر آثار دارای حق نشر برای ایجاد مجموعه داده آموزشی اصولاً به مجوز صاحب حق نیاز دارد؛ موضوعی که با برخی تفسیرهای حقوقی در آمریکا تفاوت دارد.
در نتیجه، حتی اگر شرکتهای هوش مصنوعی بتوانند کتابهای چاپی را از بازار دستدوم تهیه کنند، مسئله اسکن، ذخیرهسازی و استفاده از محتوای آنها برای آموزش مدلها همچنان میتواند محل اختلاف حقوقی باشد.
آنچه فعلاً روشن است، افزایش تقاضا برای کتابهای قدیمی و غیرمعمول در برخی بازارهای دستدوم است. اما تا زمانی که هویت خریداران و مقصد نهایی کتابها مشخص نشود، نمیتوان این روند را بهطور قطعی به شرکتهای هوش مصنوعی نسبت داد. با این حال، ماجرا بار دیگر نشان میدهد رقابت برای دستیابی به دادههای آموزشی، حتی میتواند کتابهای خاکخورده در قفسه کتابفروشیهای قدیمی را به منابعی ارزشمند برای صنعت فناوری تبدیل کند.